FMECA: cómo priorizar los modos de falla que realmente importan
Un chancador, una caldera o un camión de extracción pueden tener decenas de modos de falla creíbles. Ninguna organización tiene los recursos para tratarlos todos con el mismo nivel de detalle, y tampoco tendría sentido hacerlo: algunos modos de falla pueden detener una planta o lesionar a una persona, y otros apenas generan una reparación menor.
La pregunta práctica es cuáles atender primero. Para eso existe el FMECA (Failure Mode, Effects and Criticality Analysis, o análisis de modos de falla, efectos y criticidad).
FMEA, FMECA y RCM: qué es cada uno
El FMEA es un método sistemático para identificar cómo puede fallar cada componente de un sistema y qué efecto tiene esa falla sobre el sistema completo. El FMECA agrega una dimensión: la criticidad, que permite ordenar los modos de falla según su importancia relativa. La norma de referencia para ambos es la IEC 60812.
La relación con RCM suele generar confusión. Como vimos en el artículo sobre RCM y su árbol de decisión, las primeras cuatro preguntas de un análisis RCM (funciones, fallas funcionales, modos de falla y efectos) son en esencia un FMEA. La diferencia está en lo que viene después:
- RCM usa el análisis de modos de falla para decidir qué política de mantenimiento aplicar a cada uno, a través de la evaluación de consecuencias y el árbol de decisión.
- FMECA usa el análisis de modos de falla para priorizar: ordena los modos de falla por criticidad y define acciones para los más relevantes. Esas acciones pueden ser de mantenimiento, pero también de diseño, operación, repuestos o capacitación.
No son metodologías rivales. En la práctica se complementan: el FMECA es especialmente útil para decidir dónde concentrar un análisis RCM más profundo, o para abordar equipos con gran cantidad de modos de falla donde no se justifica un RCM completo.
El proceso, paso a paso
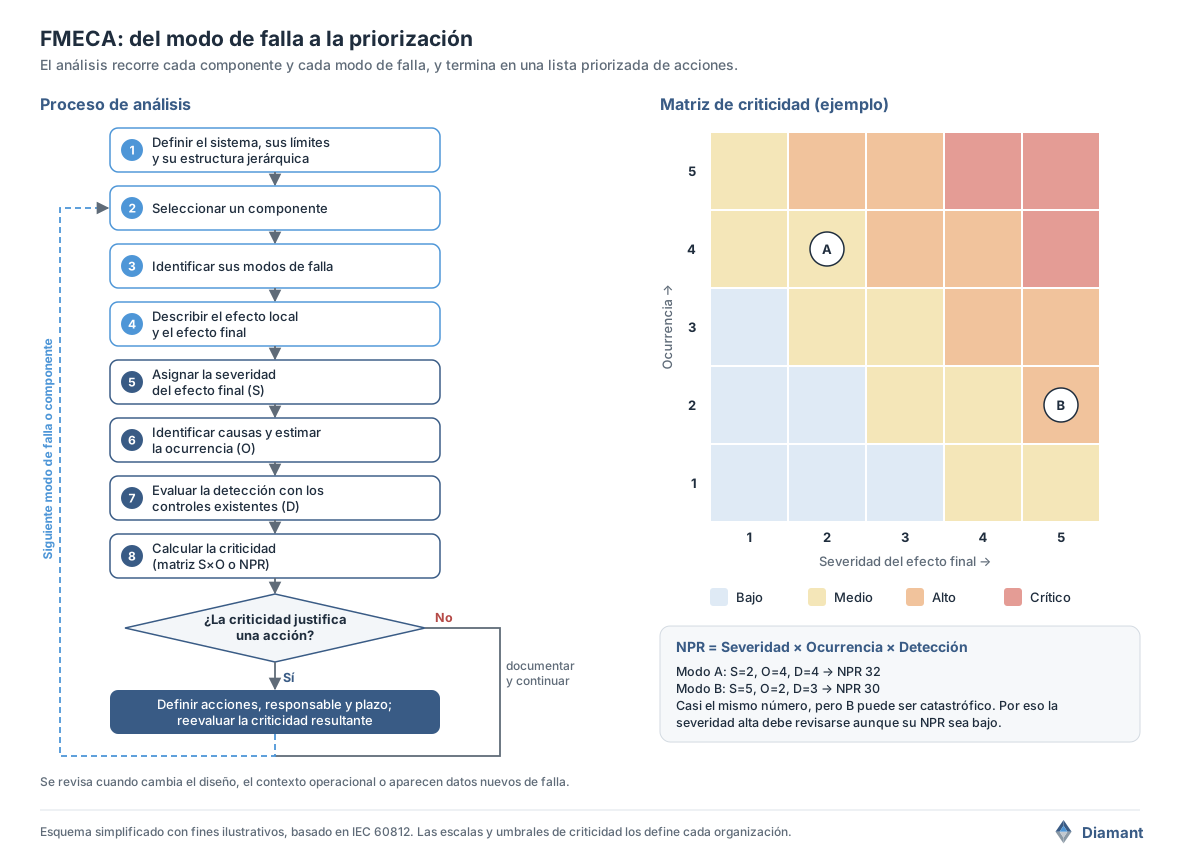
1. Definir el sistema, sus límites y su estructura. Antes de listar modos de falla hay que decidir qué se analiza y qué queda fuera, y descomponer el sistema en una jerarquía: sistema, subsistemas, conjuntos y componentes. El nivel de detalle adecuado es el más bajo para el que existe información suficiente. Un diseño maduro, con buen historial, puede analizarse a un nivel más alto; un equipo nuevo o con historial desconocido requiere más detalle.
2 y 3. Seleccionar cada componente e identificar sus modos de falla. Para cada elemento de la jerarquía se listan las formas en que puede dejar de cumplir su función: no arranca, se detiene, pierde capacidad, fuga, opera fuera de rango, etc.
4. Describir los efectos. Se distingue el efecto local, sobre el propio componente, del efecto final, sobre el sistema completo. La severidad siempre se evalúa sobre el efecto final. Un rodamiento dañado tiene un efecto local similar en dos bombas, pero si una tiene respaldo y la otra no, el efecto final es muy distinto.
5. Asignar la severidad. Se usa una escala definida para el sistema específico, por ejemplo de 1 (sin efecto relevante) a 5 (pérdida total de la función o riesgo para las personas).
6. Identificar causas y estimar la ocurrencia. Cada modo de falla puede tener varias causas. La ocurrencia es la frecuencia o probabilidad estimada de que el modo de falla ocurra en un período definido.
7. Evaluar la detección. Mide qué tan probable es detectar el modo de falla, con los controles existentes, antes de que su efecto se manifieste. Una puntuación alta de detección significa que es difícil de detectar, lo que aumenta su criticidad.
8. Calcular la criticidad y decidir. Si la criticidad justifica una acción, se definen medidas concretas, un responsable y un plazo, y se reevalúa la criticidad resultante. Si no, el modo de falla queda documentado y el análisis continúa con el siguiente.
Dos formas de medir la criticidad
La matriz de criticidad
La forma más visual es una matriz de severidad por ocurrencia. Cada modo de falla se ubica en una celda, y las zonas de la matriz se clasifican en niveles de riesgo (bajo, medio, alto, crítico). La matriz se puede usar de forma cualitativa, con categorías como "remoto" u "ocasional", o cuantitativa, asignando rangos de probabilidad a cada fila.
Una observación de la propia norma que conviene tener presente: la matriz permite comparar adecuadamente solo modos de falla del mismo nivel jerárquico. Comparar un modo de falla de un componente con uno de un sistema completo lleva a conclusiones erróneas, porque los niveles inferiores naturalmente tienen menor frecuencia.
El Número de Prioridad de Riesgo (NPR)
La forma más difundida es el NPR, que multiplica tres puntuaciones:
NPR = Severidad × Ocurrencia × Detección
Es simple y permite ordenar rápidamente una lista larga. Pero tiene limitaciones importantes, varias de ellas advertidas por la propia norma:
- El mismo NPR puede representar riesgos muy distintos. En el ejemplo de la imagen, el modo A (severidad baja, ocurrencia alta) y el modo B (severidad máxima, ocurrencia baja) tienen prácticamente el mismo NPR. Pero B puede ser catastrófico, y A no.
- Las escalas son ordinales, no proporcionales. Una severidad 4 no es "el doble" de una severidad 2. Multiplicar puntuaciones ordinales produce un número que parece preciso, pero no lo es.
- No todos los valores son posibles. En una escala de 1 a 10, muchos números entre 1 y 1.000 no pueden obtenerse como producto de tres factores, por lo que los "saltos" entre NPR consecutivos no son uniformes.
- Es muy sensible a pequeñas variaciones. Subir un punto en un factor puede cambiar el orden de prioridad de forma desproporcionada.
La recomendación práctica: usar el NPR para ordenar, pero nunca dejar que un NPR bajo oculte una severidad alta. Cualquier modo de falla con severidad en el nivel máximo debe revisarse, independiente de su NPR.
Los errores más frecuentes
Empezar sin escalas definidas. Las escalas de severidad, ocurrencia y detección deben definirse y acordarse antes del análisis, para el sistema específico. Si cada participante interpreta "severidad 4" a su manera, la priorización pierde consistencia.
Estimar la ocurrencia "a ojo" cuando existe historial. En equipos en operación, las órdenes de trabajo y los registros de falla son la mejor fuente para estimar la ocurrencia. Ignorarlos y puntuar por percepción es uno de los sesgos más comunes.
Confundir detección con inspección. Detección no significa "tenemos una inspección programada". Es la probabilidad real de que los controles existentes identifiquen el modo de falla a tiempo. Una inspección visual mensual no detecta un modo de falla que se desarrolla en horas.
Terminar el análisis en la planilla. Un FMECA que identifica modos de falla críticos pero no asigna acciones, responsables ni plazos es un inventario de riesgos, no una herramienta de gestión. Tampoco sirve de mucho si nadie reevalúa la criticidad una vez implementadas las acciones.
Ignorar sus límites. El FMECA analiza los modos de falla de a uno. No está diseñado para capturar bien fallas combinadas, fallas de causa común o interacciones complejas entre sistemas. Para esos casos, conviene complementarlo con técnicas como el análisis de árbol de fallas.
Tratarlo como un documento estático. El FMECA debe revisarse cuando cambia el diseño, el contexto operacional o cuando aparecen datos nuevos de falla. Un modo de falla que se consideró improbable y ya ocurrió tres veces es una señal clara de que el análisis quedó desactualizado.
Un análisis que se alimenta de la operación
Buena parte de estos errores tienen el mismo origen: el FMECA se construye lejos de los datos reales. Se hace en una planilla, en un taller de dos días, con estimaciones basadas en la memoria del equipo, y después se archiva.
En Diamant, el FMECA se construye sobre la misma estructura de activos y el mismo historial de fallas con que trabaja el equipo de mantenimiento. Así, la ocurrencia se puede contrastar con las fallas efectivamente registradas en las órdenes de trabajo, las acciones quedan asignadas y trazables, y cuando llega el momento de revisar el análisis, los datos nuevos ya están en el mismo lugar.
Conclusión
El FMECA no es un fin en sí mismo. Su valor está en responder, con criterios explícitos y documentados, una pregunta que toda área de mantenimiento enfrenta cada día: con recursos limitados, qué atender primero.
Para que esa respuesta sea confiable, necesita tres cosas: escalas bien definidas, datos reales de falla y la disciplina de convertir la priorización en acciones y revisarla en el tiempo.
¿Quiere ver cómo se construye un FMECA sobre el historial real de sus activos? Agende una demo de Diamant.